Tổng quan Self-hosted models
Tính năng Self-hosted models cho phép tenant của bạn tự triển khai và vận hành model phía sau một endpoint tương thích OpenAI. Bạn sẽ dùng bốn khái niệm dưới đây trong suốt quy trình.
Các khái niệm chính
Mục “Các khái niệm chính”| Thuật ngữ | Ý nghĩa | Dùng ở đâu |
|---|---|---|
| Self-hosted models | Khu vực quản trị trên Console để triển khai và vận hành các model riêng, tại Suy luận (Inference) → Mô hình tự lưu trữ (Self-hosted Models) | Thanh điều hướng và tài liệu hướng dẫn |
| Model | Tài nguyên bạn triển khai: một nguồn model (model source) được gắn với cấu hình tính toán và phục vụ tương ứng | Theo dõi trạng thái, Chỉnh sửa (Edit), Dừng (Stop), Khởi động lại (Restart) và Xóa (Delete) |
| Endpoint | Địa chỉ mạng ở cấp tenant hiển thị trên trang chi tiết của model | Cấu hình tham số base_url của client sau khi nối thêm /v1 |
| Served Model Name | Tên chính xác mà client dùng để gọi model | Giá trị trường model trong request body |
Lưu ý: endpoint chỉ là một địa chỉ, không phải bản thân model. Nhiều model trong cùng tenant có thể hiển thị cùng endpoint; hệ thống sẽ dựa trên giá trị model trong request để định tuyến tới đúng Served Model Name. Nếu model đã dừng (stopped) hoặc vẫn đang cấp phát (provisioning), tenant endpoint hiện trên trang chi tiết chưa đủ để bạn biết Served Model Name có gọi được hay không: một model khác đã sẵn sàng và dùng cùng tên vẫn có thể đang phục vụ tên đó.
Chọn Platform models hay self-hosted models?
Mục “Chọn Platform models hay self-hosted models?”| Tiêu chí | Platform models | Self-hosted models |
|---|---|---|
| Đơn vị vận hành | Do OneNexus trực tiếp quản trị | Do chính tenant của bạn quản lý qua Console |
| Workspace & GPU quota | Không yêu cầu khi gửi request | Bắt buộc phải có để triển khai và chạy model |
| API key khuyến nghị | Platform | Inference (đã cấp quyền cho Served Model Name của model tương ứng; Platform key không gọi được self-hosted model của tenant) |
| Địa chỉ kết nối | Endpoint của catalog dùng chung (shared catalog) | Tenant endpoint hiển thị trên trang chi tiết của model |
Giá trị model | Giá trị model chính xác trong lệnh cURL mẫu khi bạn mở rộng dòng của model đó | Served Model Name được cấu hình cho model |
Hãy xem Bắt đầu nhanh với Platform model nếu bạn chỉ cần gửi request thử nghiệm tới các model có sẵn trong catalog. Hãy tiếp tục hướng dẫn này khi bạn cần tự triển khai một public Hugging Face model hoặc một phiên bản model đã hoàn thiện (finalized model version) trong registry của riêng bạn.
Điều kiện tiên quyết
Mục “Điều kiện tiên quyết”Trước khi nhấn nút Triển khai mô hình (Deploy model), hãy kiểm tra:
- Bạn đã đăng nhập thành công vào OneNexus Console và chọn đúng tenant làm việc.
- Thanh tiêu đề (header) đang hiển thị đúng region bạn muốn triển khai. Workspace và GPU quota được phân bổ độc lập theo từng region.
- Tenant đã có workspace. Nếu Suy luận (
Inference) → Mô hình tự lưu trữ (Self-hosted Models) hiện Thiết lập workspace (Set up your workspace), hãy tạo workspace trước khi tiếp tục. - Mục Hạn mức (
Quotas) có phân bổ GPU cho Inference (Inference GPU allocation) trong region đã chọn. Nếu chưa có, các thao tác sử dụng GPU như Triển khai mô hình (Deploy model), Chỉnh sửa (Edit), Dừng (Stop) và Khởi động lại (Restart) sẽ ở trạng thái read-only; thao tác Xóa (Delete) vẫn dùng được để bạn giải phóng capacity đang chiếm. - Bạn đã có một nguồn model (model source) được hỗ trợ:
- Repository công khai trên Hugging Face theo định dạng
owner/name; hoặc - Một phiên bản model đã hoàn thiện và sẵn sàng phục vụ (finalized, servable) trong mục Mô hình (
Models).
- Repository công khai trên Hugging Face theo định dạng
- Tài khoản của bạn được cấp vai trò (role) có quyền triển khai model và tạo API key.
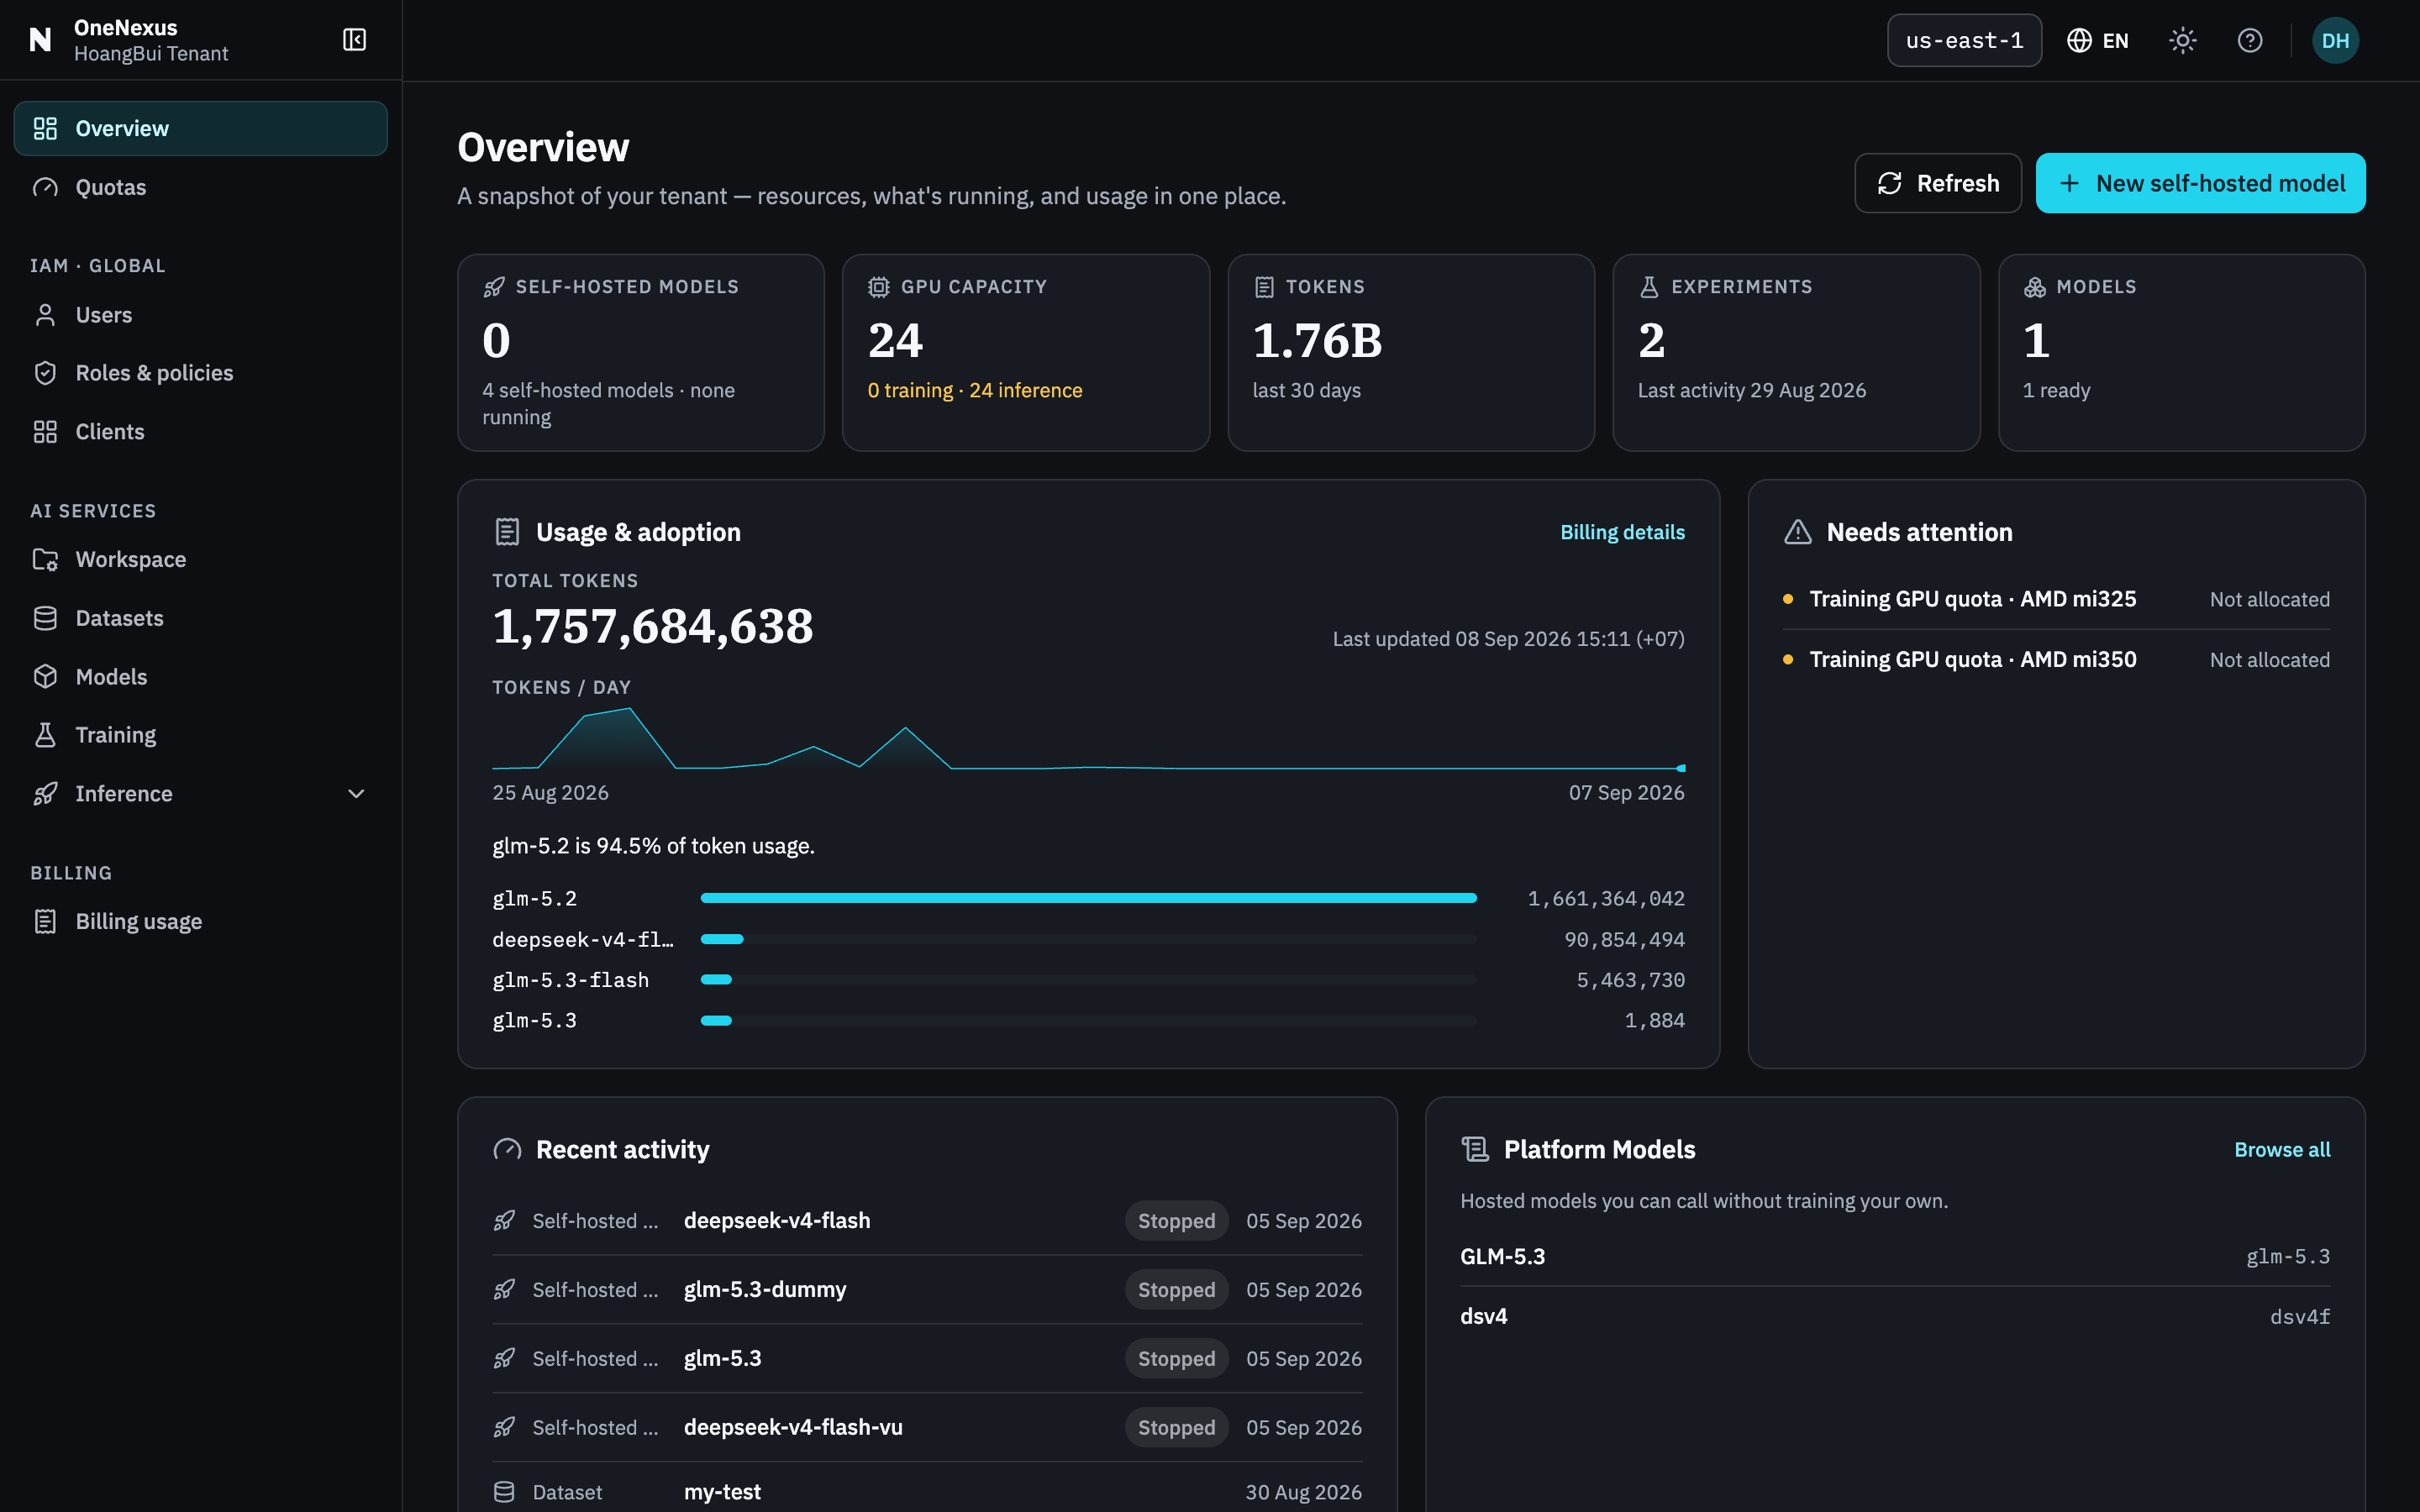
Region trên header quyết định bạn đang dùng workspace và quota nào. Hãy kiểm tra region trước tiên — cùng một tenant nhưng ở region khác sẽ có capacity khác.
Nếu còn thiếu workspace hoặc quota, hãy làm theo thao tác Console gợi ý để hoàn tất bước bàn giao (onboarding hand-off) trước khi tiếp tục. Đừng mượn workspace hay API key của tenant khác.
Quy trình triển khai lần đầu
Mục “Quy trình triển khai lần đầu”Thực hiện lần lượt theo các bước sau:
- Triển khai model đầu tiên — Chọn nguồn model, thiết lập Served Model Name, chọn Flavor phần cứng và số lượng replica, sau đó chờ model chuyển sang trạng thái
Running. - Gọi endpoint — Tạo Inference key và xác nhận model trả về phản hồi thật.
- Vận hành model — Tìm hiểu cách scale số replica, chỉnh sửa cấu hình, giám sát số liệu, dừng (stop), khởi động lại (restart) và dọn dẹp tài nguyên một cách an toàn.
- Khắc phục sự cố self-hosted model — Chẩn đoán lỗi khi cấp phát tài nguyên (provisioning) và lỗi request mà không phải đoán mò.
Điều kiện sẵn sàng (readiness gate) lúc nào cũng vậy: chỉ bắt đầu tích hợp client khi model đã ở trạng thái Running, trang chi tiết đã hiện endpoint và tab Sao chép cURL (Copy as cURL) có một request hoàn chỉnh.
Phạm vi và giới hạn hiện tại
Mục “Phạm vi và giới hạn hiện tại”- Mỗi self-hosted model sẽ phục vụ đúng nguồn model đã chọn khi tạo ban đầu. Tính năng Chỉnh sửa (
Edit) không hỗ trợ thay đổi liên kết nguồn này; nếu muốn phục vụ model khác, bạn cần tạo mới một self-hosted model. - Luồng triển khai Mô hình mở (
Open model) hỗ trợ các public repository trên Hugging Face; các repository riêng tư (private) hoặc yêu cầu quyền truy cập đặc biệt (gated) không nằm trong phạm vi của tài liệu này. - Giao diện Console cho phép chỉ định số lượng replica cụ thể. Để tắt tạm thời model, bạn cần bấm nút Dừng (
Stop); đừng mặc định rằng hệ thống sẽ tự co giãn theo lưu lượng (autoscaling) hay tự hạ số replica về 0 (scale-to-zero). - Cấu hình phục vụ và các tùy chọn request được hỗ trợ có thể khác biệt tùy theo recipe của từng model. Luôn bắt đầu từ lệnh cURL mẫu do Console tạo trước khi bổ sung các tham số tùy chọn hoặc ghi đè runtime.